
SDK的设计哲学
重要
随着软件项目的庞大,模块化开发成为必然,高内聚低耦合成为评价一个系统的重要标准。一个模块只做一件事,我们会把一些通用的代码分离出来,到其他项目中进行单独的维护,别人再通过依赖的方式使用。这就是SDK的作用。
一、 🔌 接口契约与向后兼容(最重要规范)
注
一句话定义:SDK 必须使用语义化版本号,并在同一主版本内严格遵守向后兼容承诺。
🌓 版本号即契约
提示
所有对外暴露的接口(包括构造函数、方法签名、URL 路径、配置项)都必须在首次发布时确定版本号。
比如说针对 Web API,你可以用/api/v2/users方式定义API,这样不同版本可以共存,使用者可以逐步迁移,而不是被迫一次性全改。
✍ 立刻上手: 使用@since文档注释
再比如说,我们的很多编程语言都有文档注释来标注函数或 API 的引入版本。以下是几个常见例子:
| 语言 / 工具 | 标签 / 写法 | 示例 |
|---|---|---|
Java (JavaDoc) | @since | /** @since 1.8 */ |
Python (Sphinx / reStructuredText) | .. versionadded:: | .. versionadded:: 3.6 |
C# (XML 文档注释) | <since> | /// <since>4.0</since>(非标准,常用 <remarks> 或自定义标签) |
TypeScript / JavaScript (JSDoc) | @since | /** @since 2.0.0 */ |
Rust (rustdoc) | #![doc(html_root_url = "...")] + 文本说明 | 通常写在注释中,例如 /// Available since Rust 1.30.0. |
Go (godoc) | 无专用标签,直接在注释中写明 | // Since Go 1.12, this function does ... |
核心思路:无论哪种语言,都推荐在文档注释中使用明确的标签或自然语言注明“此功能从哪个版本开始可用”。这有助于使用者快速判断兼容性。
拿我最熟悉的kotlin代码来举一个例子
在 Kotlin 的文档注释(KDoc)中,推荐使用 @since 标签来标明函数从哪个版本开始支持。这是从 JavaDoc 继承而来的标准做法,Kotlin 官方也遵循这一惯例。
示例:
/**
 * 对字符串进行某种处理。
 *
 * @param input 待处理的字符串
 * @return 处理后的结果
 * @since xxx组件名称 1.2.0
 */
fun processString(input: String): String {
    // ...
}
如果你编写的是 Kotlin 标准库级别的代码,也可以使用 @SinceKotlin 注解(如 @SinceKotlin("1.2")),标注这个API从什么kotlin版本开始支持,但这属于注解而非文档注释。文档注释中仍建议使用 @since 标签。
🌔 版本号语义化
版本号本身要传达含义,通常指遵循 SemVer(语义化版本) 规范,格式为 主版本.次版本.补丁:
- 主版本递增:做了不向后兼容的改动(比如删了一个方法、改了参数类型)。使用者需要修改代码才能升级。
- 次版本递增:新增了功能或接口,但旧代码依然能用。使用者可以放心升级。
- 补丁递增:只修了
bug,没改任何外部行为。升级无风险。
📃 举个例子说明版本语义化
假设你开发了一个短信发送 SDK,最初发布版本 1.0.0,有一个方法 sendSms(phone, text)。
- 后来你想增加一个
sendVoiceCode(phone)的新功能,但不影响旧的sendSms→ 版本号升为1.1.0(次版本+1)。使用者无需改代码就能享受新功能。 - 再后来你发现
sendSms的参数顺序不合理,想改成sendSms(text, phone)→ 这是不兼容改动,版本号升为2.0.0(主版本+1)。使用者必须手动调整调用代码。 - 如果只是修复了某个国际号码的编码 bug,没有任何接口变化 → 版本号升为
1.1.1(补丁+1)。使用者可以无缝升级。
🌕 主版本内的铁律
重要
在同一个主版本下,不得以任何方式破坏调用方的现有代码。
这意味着:
- 所有对外暴露的接口都必须在首次发布时确定版本号(如使用
@since文档注释) - 不能删除或重命名已公开的类、方法、常量。
- 不能修改已有方法的参数列表、返回值类型或抛出的异常类型。
- 新增字段或方法时,必须确保旧代码不受影响(例如使用默认值、可选参数、重载方法而非修改签名),不能导致旧代码编译失败或运行出错。
- 返回结果只增不减(例如
JSON响应中新增字段不影响旧解析器,除非对方严格校验schema)。 - 废弃的接口必须保留至少一个次版本周期,并用
@Deprecated等标注明确提示。 - 每次发布(
release或发布到软件包仓库)必须更新版本号,并在变更日志中写明变更。
👩🔬 为什么接口契约如此重要
因为 SDK 是被无数下游项目依赖的“积木”,随意修改会导致下游崩溃。如果没有版本化和语义化,使用者无法知道升级会不会炸掉自己的代码,最终要么不敢升级,要么出问题后骂你。有了这套规则,双方都能轻松管理依赖关系。
一旦打破向后兼容,就必须提升主版本号。这是对使用者的基本尊重——让他们能够根据版本号判断升级风险,决定何时迁移。
🙅♀️ 错误的做法
- 直接修改已有方法的参数类型而不升主版本;
- 将某个方法的返回值从
String改为int; - 删除已公开的常量。删除了一个被大量引用的工具类。
👉 举一个反例: 同星TSMaster API的兼容性问题
先来看一个,2023年的同星TSMaster API,是如何接收一组报文的,真实源代码如下,此时的函数签名还是tsfifo_receive_can_message_list
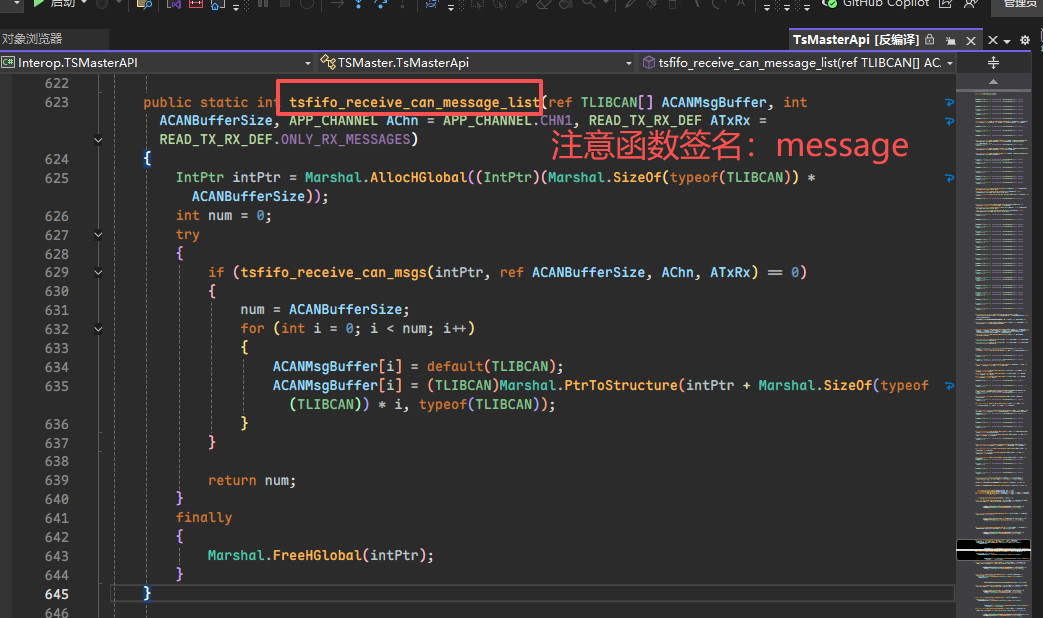
我们再来看一下,2025年的同星TSMaster API是如何接收一组报文的。
警告
截图为证,同星的工程师们,你们别抵赖哈!!
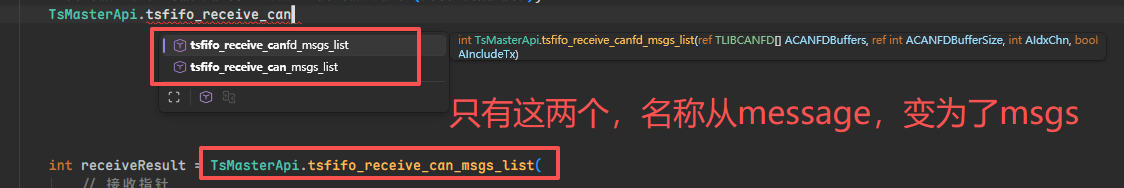
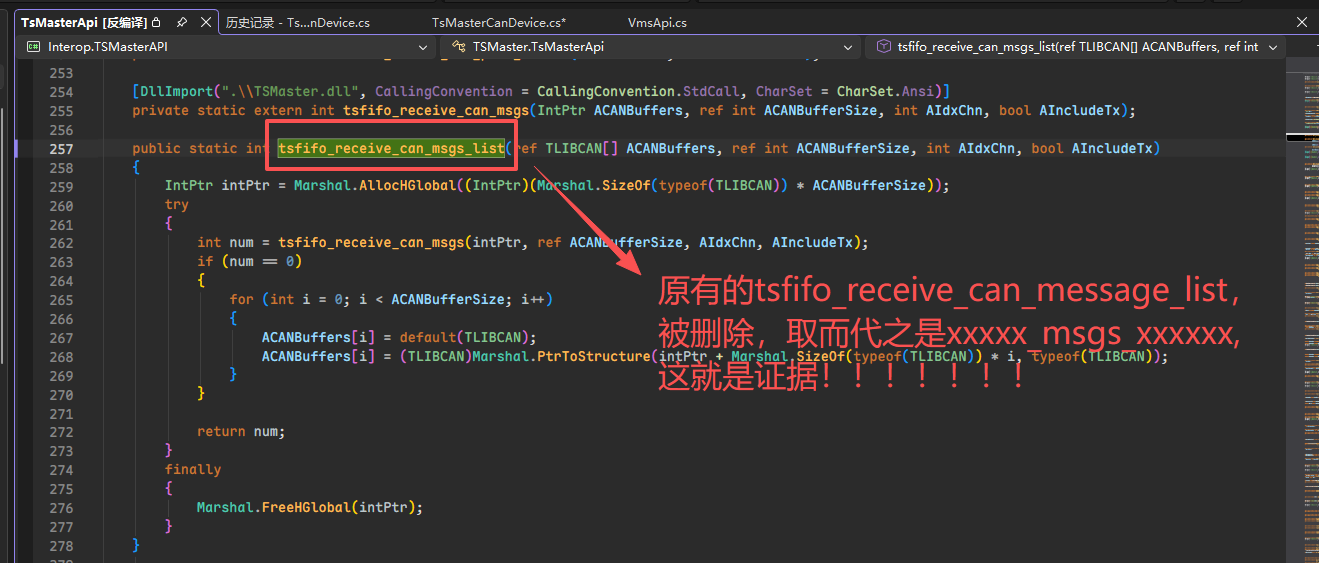
原来的tsfifo_receive_can_message_list函数直接被删除了,替换成了tsfifo_receive_can_msgs_list,并且函数的参数的类型也乱改了。
可能同星TSMaster API的工程师觉得,我既然是读取 一组 报文,那名称命名为 msgs应该很合理吧。你是觉得很合理了,那你有考虑过用户的感受吗,2023年还是message,到了2025年直接变成msgs,原来的上位机程序直接无法运行了。
这就是我前边一直说的:接口就是契约,这件事非常重要,我承诺一旦我的SDK发布,我的函数签名将不会有任何改动。好在他们的 DLL 没有通过 NuGet 公开发布,否则每个版本都不兼容,整个生态都会炸掉。关于如何将软件包发布到公共仓库,可以看我之前的博客。
正确的做法
那同星工程师正确的做法是什么?
- 绝不修改函数签名,即便已经不再维护了,也要继续给用户提供,这是对使用者的基本尊重。
- 凡是公开的接口契约,注明发布的起始日期。
- 升级时,保留原有的函数签名,同时提供旧版和新版,给旧版打上弃用标记,引导用户使用新版。
示例代码如下:
/// <summary> 从缓冲队列中读取一组报文 </summary>
/// <since>2025.12.13</since>
public static int tsfifo_receive_can_msgs_list(ref TLIBCAN[] ACANBuffers, ref int ACANBufferSize, int AIdxChn, bool AIncludeTx) {
    IntPtr intPtr = Marshal.AllocHGlobal((IntPtr)(Marshal.SizeOf(typeof(TLIBCAN)) * ACANBufferSize));
    try {
        int num = tsfifo_receive_can_msgs(intPtr, ref ACANBufferSize, AIdxChn, AIncludeTx);
        if (num == 0) {
            for (int i = 0; i < ACANBufferSize; i++) {
                ACANBuffers[i] = default(TLIBCAN);
                ACANBuffers[i] = (TLIBCAN)Marshal.PtrToStructure(intPtr + Marshal.SizeOf(typeof(TLIBCAN)) * i, typeof(TLIBCAN));
            }
        }
        return num;
    }
    finally {
        Marshal.FreeHGlobal(intPtr);
    }
}
// 以下是正确做法

/// <summary> 从缓冲队列中读取一组报文 </summary>
/// <since>2023.6.14.901</since>
[Obsolete("该接口已废弃,请使用 tsfifo_receive_can_msgs_list 替代")]
public static int tsfifo_receive_can_message_list(ref TLIBCAN[] ACANMsgBuffer, int ACANBufferSize, APP_CHANNEL AChn = APP_CHANNEL.CHN1, READ_TX_RX_DEF ATxRx = READ_TX_RX_DEF.ONLY_RX_MESSAGES){
    /* 省略 */
}
二、 🚪 最小惊奇原则:设计层抹除心智负担
注
一句话定义:一个好的设计,从设计层面就把使用者的心智负担抹掉了——用户不需要猜、不需要试错、不需要读文档,看到的那一刻动作已经定了。
这句话源于唐纳德·诺曼的《设计心理学》:好的设计让东西自己会说话,坏的设计逼用户读说明书。
💡惊奇感公式
💡 惊奇感的来源 = 实际行为 − 用户预期
- 差值为 0 (刚好达到用户预期) → 零心智负担(理想态)
- 差值为正 (超出用户预期) → 意外之喜(但更多时候是"咦?怎么会这样"的困惑)
- 差值为负 (没有达到用户预期) → 踩坑、报错、反直觉(最糟糕)
优秀的设计师做的不是"创造惊喜",而是把这个差值压缩到趋近于零——让用户的所有预测都命中,所有动作都有预期内的结果。这就是"好的设计是透明的":你感受不到它,因为你从来不需要去思考它。
🎄现实世界中的最小惊奇
最小惊奇原则,不单单是软件开发独有的设计原则,而是现实世界的工程应用都应该遵循的原则。
🚪 一扇门的设计哲学
反面:玻璃门装了把手,你伸手一拉,发现是"推"的,撞玻璃上。再看对面贴了个"推",但你进门那一刻还是得先用身体试错。这就是心智负担——你要先解读"这个把手是装饰还是真的能拉"。
正面:诺曼的设计——"推"的门做成平板,"拉"的门装明显能握的把手。你看到那瞬间动作已经定了,根本不需要贴"推/拉"两个字。标签本身就是设计失败的补丁——当你需要写说明告诉用户怎么用,说明产品本身没说清楚。
或者直接做成双向可推拉的门——彻底消灭正确或错误的使用方式。
🚗 汽车工业的三个例子
单踏板模式:传统车有两个踏板——油门加速、刹车减速。这是物理世界几十年的肌肉记忆。单踏板模式把"松油门=刹车"做成默认行为,在紧急情况下驾驶员的本能是"猛踩刹车",但肌肉记忆可能让他们误踩油门。设计违背了全人类几十年的驾驶直觉。 这不是技术不行,是惊奇感差值太大。
隐藏式门把手:正常门把手是凸起的,你一拉就开,三岁小孩都知道怎么用。隐藏式门把手呢?每个品牌的弹出方式都不一样——有的按一下弹出来,有的要按特定位置、特定力度。站在一辆不熟悉的车门前,你连"怎么把把手弄出来"都不知道。一个本该零思考的动作,变成了需要研究和试错的操作。
雨量传感器 + 自动雨刮:传统车下雨时要经历"找拨杆 → 判断雨量 → 选档位 → 雨变大再调 → 雨变小再调"——你一直在手动维护雨刮状态。雨量传感器把这个循环全砍了:感应雨量 → 自动调速,从毛毛细雨到倾盆大雨,你只管看路。消除的不是操作难度,而是操作本身。
🔌 USB-C vs Lightning vs Micro-USB
反面:Micro-USB 有方向性,插反了怼不进去。USB-B 好一点了,接口变成了对称的,但是经典的问题依然存在:你正着插,插不进去,你怀疑自己插反了;于是你再反过来插,还是插不进去,你蒙了;于是你又再反过来,结果这一次插进去了,原来第一次的USB方向没有插反,但是为什么第一次又插不进去呢。
正面:USB-C 正反都能插,而且是跨品牌、跨设备的统一标准。插的动作本身零思考——你不需要先看方向、不需要辨认"这头朝上还是朝下"。 这就是物理层的最小惊奇,从设计层面消除歧义,消除用户的思考负担。
☕ 星巴克的杯型问题
你到星巴克点一杯咖啡☕。
你说你要一杯中杯,你期望的是小中大的那个中杯(约473 ml)。
服务员问你,“您确定要中杯吗?”;你说你确定以及肯定要中杯。
结果服务员给了你小号(约355 ml)的杯子。
你急了,你不能理解,为什么最小的不叫小杯要叫中杯。
服务员给你解释,他们最小的就是中杯(约355 ml)。
下边的视频就是罗永浩老师最经典的星巴克杯型问题:
https://www.bilibili.com/video/BV1yz411B7Hm
这就是期望落空——💡 惊奇感的来源 = 实际行为 − 用户预期,顾客的预期没有达到。
星巴克杯型容量表:
| 英文杯型 | 中文菜单叫法 | 容量 | 名称本意 |
|---|---|---|---|
| Short | 小杯(菜单隐藏) | 8 oz / 约 236 ml | 英文"短的" |
| Tall | 中杯 | 12 oz / 约 355 ml | 英文"高的" |
| Grande | 大杯 | 16 oz / 约 473 ml | 意大利语"大的" |
| Venti | 超大杯 | 20 oz / 约 591 ml(热饮) | 意大利语"二十" |
| Trenta | — | 31 oz / 约 916 ml | 意大利语"三十",仅部分冷饮 |
注
注:容量数据来自星巴克官方客服和美国/法国星巴克营养手册。
为什么?因为星巴克的杯型不叫"小中大",叫 Tall、Grande、Venti——全人类对杯子大小的直觉被一套意大利语词汇强行替换了,你点单时被迫在脑子里做翻译。这不是品牌调性,这是命名体系和用户心理模型错位。 所以才有了网上铺天盖地的"星巴克杯型梗"——锅不是顾客的,是命名体系的。
注
罗永浩原话是:这就是把消费者当成傻X的企业。
🏬"观瀑亭"和"听雨轩"
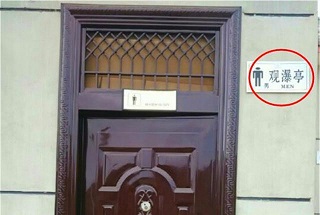
你去景区旅游,你憋了一肚子尿,你来到卫生间门口,看见"观瀑亭"和"听雨轩",以及"涤尘堂"、"御净轩"等。你想破脑筋也不知道哪个是男厕所,哪个是女厕所,这就是期望落空。
观瀑亭:
听雨轩:
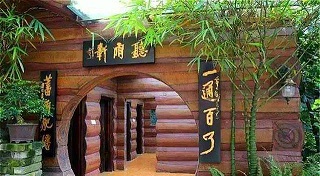
图片资料来源:https://k.sina.com.cn/article_6404127869_17db73c7d00100up6y.html
🎨 图标设计:看得懂 vs 猜不透
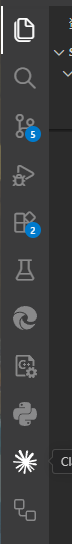
VS Code:图标风格统一,含义清晰——文件夹是文件夹,搜索是搜索,Git 分支是 Git 分支。看一眼就知道点哪里。
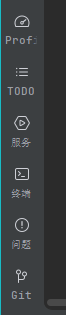
JetBrains IDEA:图标同样清晰,且支持附带文本标签——图标 + 文字双重确认,消除歧义。
反面教材 ——
TSMaster:部分图标设计模凌两可,用户看到后不知道点下去会发生什么,只能一个一个试。下面是截图对比: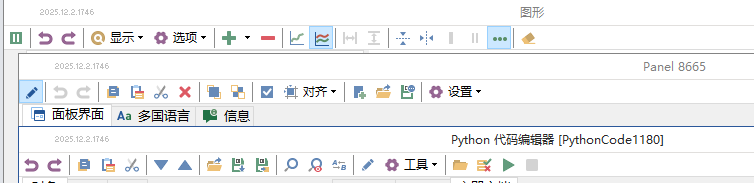
TSMaster模凌两可的图标,还没有文字
如果图标表意不清晰,建议都加上文字说明。
💻软件 API 中的最小惊奇
上面都是物理世界的例子。回到 SDK 设计,最小惊奇原则落地为几条硬规范:
1. 函数命名即契约:副作用可见,无隐式魔法
规范:
- 方法命名必须符合平台和行业通用的动词约定。使用者不需要查文档就能推断一个方法的行为。
- 副作用应当最小化(避免隐式魔法行为),函数名称是什么就做什么;有副作用的方法必须用动词明确标注。任何"自动帮你做的事"都需要在文档或方法名中明确声明。
| 前缀或后缀 | 预期行为 | 示例 |
|---|---|---|
get | 返回只读对象,不修改状态 | getUser(id) |
getOrCreate | 读取不到则创建一条记录(副作用可预测) | getOrCreateUser(id) |
fetch | 单纯获取,不会重试 | fetch(url: String) |
WithRetry | 执行失败会重试(副作用可预测) | fetchWithRetry(url: String, maxRetries: Int = 3) |
find | 查询,可能返回空 | findUsers(filter) |
create / build | 新建资源 | createClient(config) |
delete / remove/close | 删除资源(应当是幂等的,反复执行关闭操作不应当报错) | deleteFile(path) |
update / set | 修改已有资源 | updateProfile(user) |
is / has / can | 返回布尔值 | isConnected()、hasPermission() |
反例:
getUser应该是只读,不会产生副作用;却在内部偷偷创建了一个新用户并写入数据库;processData应该只处理数据,既不返回数据也不修改数据;但是却发了封邮件——没人能从名字猜出它干了什么。
2. 参数顺序符合常识
规范:参数排列应遵循"先主要后次要、先输入后输出、先目标后内容"的自然语序。
// ✅ Java 标准库:source 在前,destination 在后——几十年没变过
System.arraycopy(src, srcPos, dest, destPos, length);

// ❌ 反直觉:把 dest 放在 src 前面——每次调用都要停顿想一下
System.arraycopy(dest, destPos, src, srcPos, length);
从源数组到目标数组,非常符合使用直觉。
3. 返回值一致且可预测
规范:同一个模块中,相似场景的返回值类型必须一致。查询"找不到"时统一返回空值,不混用 null 和空集合。
// ✅ 一致:找不到时都返回空列表
fun findUsersByAge(age: Int): List<User>   // 可能返回 emptyList()
fun findUsersByTag(tag: String): List<User> // 同样返回空列表

// ❌ 不一致:一个返回 null,一个返回空列表,一个抛异常
fun findUsersByAge(age: Int): List<User>?   // 可能返回 null
fun findUsersByTag(tag: String): List<User>  // 返回空列表
fun findUsersByCity(city: String): List<User> // 找不到就抛 NoSuchElementException
调用方要写三套不同的判空逻辑。这就是心智负担——不是在用你的 API,是在防御你的 API。
🙅♂️反面例子: 周立功27服务安全算法的函数签名
汽车电子行业里,UDS 诊断协议的 0x27 服务(SecurityAccess)要求 ECU 供应商提供一个 DLL,整车厂调用它来解锁 ECU。国内两大供应商——周立功(ZLG)和 Vector——各自给出了模板。同一个功能,签名天差地别。
// 周立功版:❌ 返回 int(魔法返回值, 不清楚返回值含义),❌ 前缀全标 i(说谎),❌ 没有缓冲区容量(隐式越界风险)
extern "C" int ZLGKey(
    const unsigned char* iSeedArray,
    unsigned short iSeedArraySize,
    unsigned int iSecurityLevel,
    const char* iVariant,
    unsigned char* iKeyArray,              // 标了 i,但实际上是输出缓冲区 (有副作用,但没有说明)
    unsigned short* iKeyArraySize          // 标了 i,但函数会修改它的值 (有副作用,但没有说明)
);
而 Vector 的同一功能,签名里把一切都说明白了:
// Vector 版: ✅ 枚举返回值(避免了魔法返回值) + ✅ i/io/o 三分前缀 + const 修饰 + ✅  缓冲区容量
/* Vector 安全算法 GenerateKeyEx 的返回值 */
enum VKeyGenResultEx {
	/* 完成 */
	KGRE_Ok = 0,
	/* 缓冲区太小 */
	KGRE_BufferToSmall = 1,
	/* 安全等级无效 */
	KGRE_SecurityLevelInvalid = 2,
	/* 变体参数无效 */
	KGRE_VariantInvalid = 3,
	/* 未指定错误 */
	KGRE_UnspecifiedError = 4
};

KEYGENALGO_API VKeyGenResultEx GenerateKeyEx(
    const unsigned char*  ipSeedArray,           // i  → 纯输入
    unsigned int          iSeedArraySize,        // i
    const unsigned int    iSecurityLevel,        // i
    const char*           ipVariant,             // i
    unsigned char*        iopKeyArray,           // io → 既是输入,也是输出;会被填充
    unsigned int          iMaxKeyArraySize,      // i  → 缓冲区容量,纯输入
    unsigned int&         oActualKeyArraySize    // o  → 纯输出
);
同样的功能,同一个行业。好的签名跟你诚实交代每一个参数的角色,烂的签名让你猜。 和第四章呼应——KGRE_BufferToSmall 不只是"出错了",它在告诉调用方接下来该做什么(缓冲区太小),而周立功的 -1 什么都没说。
👍正面例子:kotlin的正则表达式类
Java 的正则表达式API
Java 的正则 API 是典型的“让你猜”设计:明明一个类就能解决的问题,Java非要设计成Pattern 和 Matcher 两个类。一个Matcher类使用一次匹配方法之后不能立刻再次使用,因为匹配一次之后,内部游标已经移动到了末尾,再次匹配直接出问题,非常容易踩坑踩坑。
// Java —— 状态管理是隐形的陷阱
Pattern p = Pattern.compile("\\d+");
Matcher m = p.matcher("123abc");

System.out.println(m.matches()); // true(整个字符串匹配?其实只是从开头匹配到了数字)
m.find();                         // 此时游标在末尾
System.out.println(m.find());     // false!你以为还能找到,但其实游标已经到头了

// 想再用?必须先 reset()
m.reset();
System.out.println(m.find());     // true(终于对了,但谁记得要 reset?)
调用方必须记住“用完要 reset”,否则第二次重复调用就失效——心智负担藏在 API 的状态管理里。更别提反斜杠转义 \\d 写起来像在折磨手指。
Kotlin 的正则表达式API
Kotlin 的 Regex 类一刀切掉了这个包袱。kotlin没有写新的逻辑,而是原样保留了Java的Pattern 和 Matcher ,并在此基础上重新封装成了一个Regex 类。
Regex 类本身只持有两个不可变字段:原始的 pattern 字符串和 options 选项集,真正编译后的 Pattern 对象是延迟初始化的:
public actual class Regex(
    public val pattern: String,
    public val options: Set<RegexOption>
) : Serializable {

    // 内部持有的 Java Pattern,作为“原生模式”
    private val nativePattern: Pattern =
        Pattern.compile(pattern, options.toPlatformFlags())

    // 对外提供 matches / find / findAll / replace / split 等方法
    public actual infix fun matches(input: CharSequence): Boolean =
        nativePattern.matcher(input).matches()
}
如何使用:
// Kotlin —— 每次调用独立,状态透明
val regex = Regex("""\d+""")  // 原始字符串,告别双重转义

val result1 = regex.containsMatchIn("abc456") // true
val result2 = regex.find("abc456")            // MatchResult("456")
val result3 = regex.findAll("a1b2c3").toList() // [MatchResult("1"), MatchResult("2"), MatchResult("3")]

// 以上三次调用互不影响,不需要 reset,不需要担心游标matches、containsMatchIn、findAll 每次调用都是独立从头扫描,不存在“游标污染”。再加上原始字符串 """\d""" 免去双重转义,捕获组通过解构直接取值:
val dateRegex = Regex("""(\d{4})-(\d{2})-(\d{2})""")
val (year, month, day) = dateRegex.find("2025-03-12")!!.destructured
println("$year年$month月$day日") // 2025年03月12日
你不需要知道底层有个 Matcher 在动,甚至不需要知道 Pattern 的存在。 API 把自己做透明了,用户只需要写“我要匹配什么”,剩下的交给语言。这就是最小惊奇——从设计层面把使用者的心智负担抹掉了。
👍正面例子:Smart-dbc自动处理文件编码格式
Smart-dbc是我的一个开源项目——一个Kotlin/JVM车载通信中间件,提供DBC文件的解析、生成、编辑能力,支持注解驱动的CAN报文编解码,已发布至Maven中央仓库。地址:https://github.com/shilic/smart-dbc
汽车电子行业有个著名的烂摊子:TSMaster 编辑的 DBC 文件是 UTF-8 编码,Vector 的 CANdb++ 编辑的是 GBK 编码。你用 TSMaster 打开 Vector 导出的 DBC——中文注释全是乱码;反过来也一样。两边工具都"没错",但用户必须手动记住"这个文件是谁家的、要用什么编码打开"——故意给用户制造使用负担。
Smart-dbc 则直接把这个负担抹掉了:自动识别文件编码。
第一版方案:需要用户手动传编码参数
// ❌ 第一版 API:用户必须自己先检测编码,再传给主函数
val charset = File("example.dbc").detectEncoding()   // 第一步:检测
val dbc = File("example.dbc").toDbc(charset)         // 第二步:传入

// 一个操作拆成两步,多传一个参数。如果用户忘了检测,
// 直接用 toDbc(),中文注释全部乱码——错误是静默的,不会报异常。
这违背了最小惊奇:用户只是"想读一个文件",凭什么还要额外传文件编码?
为什么不能内部自动检测?
因为编码检测和 Matcher 一样——会消费文件流。检测函数要把文件从头读到尾才能判断编码,读完流就移动到末尾了。而 InputStream 天生没有 reset() 能力(磁盘文件流不可回退),你没法"检测完再从头读一遍"。所以第一版才逼用户手动传编码。
第二版方案:把"打开文件"变成一个函数
既然一个流不够用,那就打开两次文件:
// ✅ 第二版 API:参数类型从 InputStream 变成 () -> InputStream
fun (() -> InputStream).toDbc(): DataBaseCanImp = DbcFileReader(provider = this).read()

// 内部实现:
// 第一次调用 provider() —— 拿到第一个流,检测编码
// 第二次调用 provider() —— 重新打开文件,用检测到的编码解析
val aEncoding: Charset = encoding ?: provider.encoding() ?: DefaultCharset
fun read(): DataBaseCanImp = provider().reader(aEncoding).buffered().use { parseLines(it) }传入的不是"文件流",而是"一个能反复提供文件流的函数"。检测器需要流时调一次,解析器需要流时再调一次——两次拿到的是两个全新的流,各用各的,互不干扰。用户只需要写:
// 用户视角:一行代码,零编码负担
val dbc = File("example.dbc")::inputStream.toDbc()
// 或者更简单:
val dbc = File("example.dbc").toDbc()检测编码这件事从用户的心智里彻底消失了——BOM 检测(bomDetector)和内容嗅探(universalDetector)都在 SDK 内部完成,检测不到就回退 GBK(汽车行业事实标准)。
兼容性:保留编码参数
虽然自动检测覆盖了 99% 的场景,但永远有 1% 的特殊情况(比如自定义编码、无 BOM 的罕见编码)。所以编码参数依然保留,只是变成了带默认值的可选参数:
// 用户可以强制指定编码,也可以完全不传
class DbcFileReader(
    val encoding: Charset? = null,   // null = 自动检测
    /* ... */
)
// 内部解析优先级:用户显式指定 > 自动检测 > GBK 兜底
val aEncoding: Charset = encoding ?: provider.encoding() ?: DefaultCharset
自动检测是默认,手动指定是逃生舱。 大多数用户永远不需要知道有编码这回事,少数需要的人仍然有路可走。这就是设计层抹除心智负担——不是把问题丢给用户,而是把问题解决在 SDK 内部。
回顾:这个 API 是怎么层层升级出来的
回头看,这个编码 API 一共经历了四层迭代,每一层都在往上一个台阶迈:
| 版本 | 设计 | 问题 |
|---|---|---|
| 第一层:能跑就行 | toDbc(inputStream, charset)——用户先手动检测编码,再传两个参数 | 能用,但把"检测编码"这个与业务无关的负担甩给了用户。多一个参数就多一次记错的机会 |
| 第二层:想内部化,撞墙了 | 试图在 SDK 内部自动检测——但检测函数会消费文件流,和 Matcher 一样游标走到末尾。InputStream 没有 reset(),一个流不够用 | 技术上卡死了,第一层是被迫的 |
| 第三层:换一种输入类型 | 把参数类型从 InputStream 改成 () -> InputStream——传入"打开文件的函数",而不是"已打开的文件"。检测时调一次,解析时调一次,两次各拿一个全新流 | 参数从两个变一个,用户视角彻底消灭了编码概念 |
| 第四层:留逃生舱 | 保留可选编码参数,默认 null(自动检测)。优先级:显式指定 > 自动检测 > GBK 兜底 | 99% 的用户零负担,1% 的特殊场景仍然可控 |
API 设计不是一次性设计出来的,是一次次"逼"出来的。 第一版 API 带着用户负担发布没关系——先跑起来,用起来,然后问自己:"用户写这段代码时,脑子里被迫想了他本不需要想的东西吗?"如果是,就把那个东西塞回 SDK 内部。第二层撞墙了也没关系——墙告诉了你 InputStream 的边界,换一种输入类型就是解法。心智负担不会自己消失,它只会被一层一层地磨掉。
三、 🥊 最小依赖原则:零冗余,不绑架
注
一句话定义:SDK 运行时只依赖绝对必要的底层库,且优先选择标准库或业界广泛使用的轻量库;所有可选功能做成可选,由调用方自行决定是否引入。
为什么依赖要最小化
你引入一个第三方库,表面上只是加了一行 implementation。实际上你替所有使用者做了以下决定:
- 版本冲突:使用者的项目里已经有
okhttp 4.9,你的 SDK 硬编码依赖okhttp 4.12——构建工具会自动把4.9静默升级成4.12。这会存在潜在冲突。 - 包体积膨胀:一个几百
KB的SDK因为传递依赖变成几MB,对于移动端或边缘设备来说是灾难。 - 安全漏洞传播:每多一个依赖就多一个潜在的攻击面。如果某个传递依赖爆出高危漏洞,你的 SDK 也会被牵连。
- 许可证污染:你引入了一个
GPL协议的库,使用者的商业项目被迫开源。
每引入一个依赖,你都是在替使用者做决定——而他们没有否决权。
怎么做
硬性标准:
- 运行时依赖只能包含底层设施:
JSON解析、HTTP客户端、加密库、Excel解析库——这些你不可能自己写的底层设施 - 优先选择标准库。能用
java.net.http就不用OkHttp,能用kotlinx.serialization就不引入Gson - 每次新增依赖前问自己:"我能不能用 20 行代码代替这个库?"如果能,自己写
- 定期审查依赖树,看哪些依赖实际上只用了其中一两个方法
反面例子1:滥用工具库
// ❌ 一个小工具 SDK,依赖却比业务项目还重
dependencies {
    implementation("com.google.guava:guava:32.0.0-jre")      // 只用了 Preconditions.checkNotNull
    implementation("org.apache.commons:commons-lang3:3.12.0") // 只用了 StringUtils.isBlank
    implementation("com.google.code.gson:gson:2.10.0")       // 只做了一处 JSON 序列化
}
三个库加起来几 MB,SDK 自己的代码才几百行。这不是"为了省事",这是"把使用者的项目当垃圾桶"。
// ✅ 同一个 SDK,遵循最小依赖
dependencies {
    implementation(kotlin("stdlib"))                     // 标准库,无争议
    // Guava? 自己写 checkNotNull —— 3行代码
    // commons-lang3? 自己写 isBlank —— 1行代码
    // Gson? 用 kotlinx.serialization
}
💡 一句话:你的 SDK 是使用者项目的客人,不是主人。客人不带一车行李进主人家门。
反面例子2:同星TSMaster API
哈哈,我又来给同星TSMaster API鞭尸了,感觉像是为了这一叠醋,包了这一盘饺子是吧(写这篇博客)。是的,这篇博客的一大目的通过同星TSMaster API的反面例子来讲SDK的设计规范。
下图是我上位机的真实报错,为什么发生这个问题呢,因为我最新的UDS诊断上位机打开同星系列CAN卡的功能是基于同星TSMaster API2025版开发的,而用户的电脑上安装的是2023年甚至更早版本的同星TSMaster API。
这就导致了一个问题:上位机上内置了TSMaster API的DLL还不够。用户拿到上位机之后,不能够即插即用;还需要额外安装一个对应版本的TSMaster,必须要安装,并且版本还要对应。
- 如果用户没有额外安装
TSMaster,则报错:IDX_ERR_TSMASTER_IS_NOT_INSTALLED = 94,提示用户没有安装。 - 如果用户电脑
TSMaster API的版本不正确,可能会加载失败,报错 :IDX_ERR_LIB_LOAD_FAILED = 95。 - 如果
TSMaster API找到了,但是函数名称不正确,就是我上边第一章说的问题,就会报:IDX_ERR_LIB_FUNCTION_NOT_FOUND = 96,提示库函数未找到。
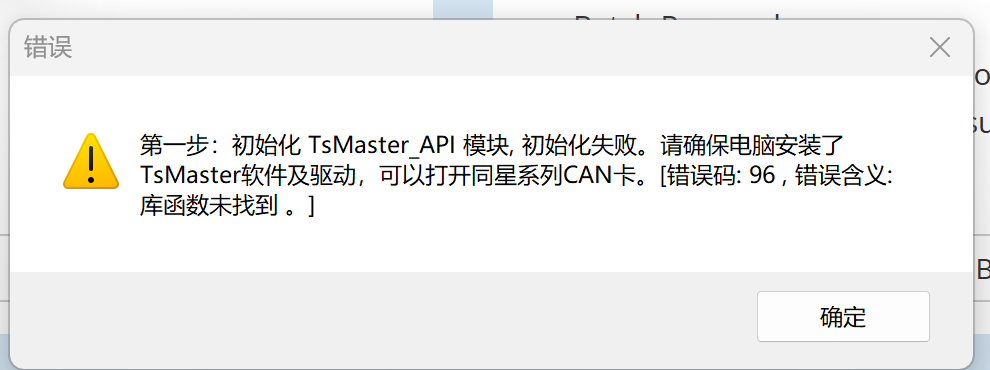
截止到2025年12月15日,同星的官方手册《TSMaster_SDK_DotNet_cn_V0.9.pdf》中,依然有这个错误码
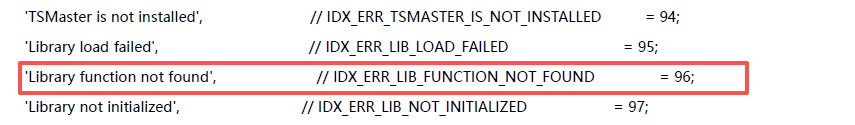
我就很纳闷了,明明上位机在二次开发的时候,就已经内置了TSMaster API,为什么还要用户额外安装一次应用程序?一个是让原本的程序体积变大了,二则是操作流程变复杂了,三是大大降低了兼容性。你说你API版本稳定了,用户安装任意版本的TSMaster就好了。你现在版本是V0.9(截至目前),API一天一个样。
提示
捆绑依赖,我认为这不是一个好的SDK应该有的行为。
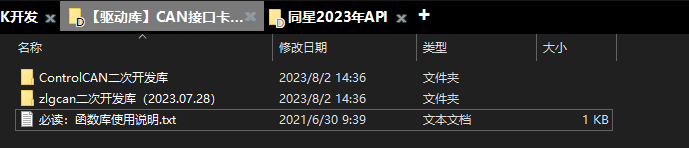
看看竞品周立功的二次开发,直接给你提供两版API:旧版你继续用,新版你也可以用。虽然周立功的 API 签名命名有小问题(第二章讲过),但至少在兼容性上——旧版 DLL 和新版 DLL 同时提供,用户即插即用,没有强迫使用者安装额外的应用程序。并且他不强制你下载ZXDoc这一类软件。二次开发的产品,即插即用,依赖非常的干净。
四、 ❌ 错误即信息:统一异常/错误码体系
注
核心思想:所有可预见的错误都要有结构化的表达,帮助调用方快速定位和处理。
- 定义基础异常类和分类子异常(如
AuthException、NetworkException、ValidationException) - 错误码采用三段式:
[服务前缀]-[错误级别]-[序号],附带人类可读消息和排查指引 - 严禁直接抛出裸
RuntimeException或返回无意义的数字码
为什么错误处理需要体系化
看一段调用方被迫写的代码:
// ❌ 调用方被迫用字符串匹配异常消息
try {
    sdk.uploadFile(file)
} catch (e: Exception) {
    when {
        e.message?.contains(“timeout”) == true -> retry()
        e.message?.contains(“auth”) == true -> refreshToken()
        e.message?.contains(“disk full”) == true -> cleanUp()
        else -> throw e
    }
}用字符串匹配异常消息来决定后续行为——这是把”接口契约”退化成了”猜谜游戏”。一旦你更新 SDK 改了错误消息的文字,这段代码就静默失效。
怎么做: 错误即信息
定义异常层级:
// ✅ 结构化的异常体系
open class SdkException(message: String, cause: Throwable? = null)
    : RuntimeException(message, cause)

class AuthException(message: String) : SdkException(message)       // 认证失败 → 刷新 Token
class NetworkException(message: String) : SdkException(message)    // 网络超时 → 重试
class ValidationException(message: String) : SdkException(message) // 参数非法 → 修正参数
class ServerException(val statusCode: Int, message: String) : SdkException(message) // 服务端错误调用方的代码从猜谜变成了类型匹配:
// ✅ 调用方可以程序化地处理不同错误
try {
    sdk.uploadFile(file)
} catch (e: AuthException) {
    refreshToken()
} catch (e: NetworkException) {
    retry()
} catch (e: ValidationException) {
    log.error(“参数错误: ${e.message}”)
    throw e  // 参数错误不需要重试
}
反面例子: 周立功27服务安全算法的函数签名
这就是为什么第二章里 Vector 的 GenerateKeyEx 返回的是 VKeyGenResultEx 枚举而不是 int:
// ❌ 周立功:返回 int,-1 和 0 说不清任何事
// 调用方拿到了 `-1`,然后呢?重试?还是参数有问题?一个 -1 告诉不了任何人任何事。
extern “C” int ZLGKey(...);

// ✅ Vector:返回枚举,每个值都是一条可操作的指令
enum VKeyGenResultEx {
    KGRE_Ok = 0,                  // 调用方:继续
    KGRE_BufferToSmall = 1,       // 调用方:调大缓冲区再试
    KGRE_SecurityLevelInvalid = 2,// 调用方:检查安全等级参数
    KGRE_VariantInvalid = 3,      // 调用方:检查变体参数
    KGRE_UnspecifiedError = 4     // 调用方:联系管理员
};
KGRE_BufferToSmall 不只是”出错了”,它在告诉调用方接下来该做什么——把缓冲区调大再调一次。而 -1 什么也没说。
💡 错误处理的本质不是”告诉用户出错了”,而是”告诉用户接下来该怎么办”。
五、 📋 日志可插拔:绝不强制绑定日志框架
注
一句话定义:SDK 通过日志门面输出,让使用者用自己的日志框架接管。不要在 SDK 里写死 println 或绑定特定日志实现。
为什么日志不能写死
使用者的项目用的是 SLF4J + Logback,你的 SDK 直接 System.out.println。结果:SDK 日志出现在控制台而非日志文件,运维看不到;无法按级别过滤;格式和项目统一格式不一致,ELK 解析不了。
你写了 println,等于替他决定了"这个信息不重要,丢控制台就行"。
正确做法1: 使用日志门面框架
// 在你的 SDK 中(面向 SLF4J 编程) ✅ 使用 SLF4J 门面
import org.slf4j.LoggerFactory

class SdkClient(private val config: SdkConfig) {
    private val logger = LoggerFactory.getLogger(SdkClient::class.java)

    fun sendRequest(data: ByteArray) {
        logger.debug("发送请求: {} bytes", data.size)
        // ...
        logger.info("请求完成: {} ms", elapsed)
    }
}
使用者自己决定日志去哪、什么级别、什么格式。SDK 的日志和他项目的日志融为一体。同时提供关闭日志的选项(如 logLevel = OFF)。
正确做法2: SDK 自定义日志接口 + 手动注入
如果你觉得引入日志框架还是太重了,或者你需要更轻量化的可插拔日志,或者你想追求极端的零外部依赖。你可以直接手写一个这样的接口即可。
SDK 侧代码:
interface SdkLogger {
    fun debug(msg: String)
    fun info(msg: String)
    fun error(msg: String)
    /* 其他日志函数 */
}

class SdkClient(
    private val config: SdkConfig,
    private val logger: SdkLogger = ConsoleLogger() // 提供默认实现
) {
    fun doSomething() {
        // SDK内部使用
        logger.info("Operation started with param ${config.name}")
    }
}
使用方需要做的事:
// 实现 SdkLogger 接口(比如基于 Logback 或 System.out)
class MyLogger : SdkLogger {
    private val log = LoggerFactory.getLogger("my-app")
    override fun debug(msg: String) { log.debug(msg) }
    override fun info(msg: String) { log.info(msg) }
    override fun error(msg: String) { log.error(msg) }
    /* 其他日志函数 */
}

// 创建 SDK 客户端时传入
val client = SdkClient(config = myConfig, logger = MyLogger())
反面例子: 直接使用 println
// ❌ 直接 println ——控制台污染,无法统一管理
fun fetchData(): Data {
    println("开始请求...")            // 格式无法统一
    val result = httpClient.get()
    println("请求完成: $result")      // 级别无法控制
    return result
}

// ❌ 硬编码依赖 Logback
import ch.qos.logback.classic.Logger  // 直接依赖实现,而非门面
💡 SDK 是客人,客人不应该擅自决定客厅的装修风格。
六、 🧪 测试与质量保障
注
一句话定义:没有测试的 SDK 不是给使用者用的,是用来折磨使用者的。最低标准:单元测试覆盖率 ≥ 80%,CI 自动化。
为什么测试在 SDK 开发中是铁律
SDK 和普通业务代码不一样——你的一个 bug,会出现在所有使用者的项目中。业务代码的 bug 只影响一个功能,SDK 的 bug 影响一整个生态。
三层测试体系
单元测试:覆盖率 ≥ 80%,重点覆盖边界条件
// 1. 单元测试:覆盖率 ≥ 80%,重点覆盖边界条件
@Test
fun `解析空 byte 数组应返回空列表而非 null`() {
    val result = decoder.decode(byteArrayOf())
    assertEquals(emptyList<Signal>(), result)  // 空输入 → 空列表,不是 null
}

@Test
fun `因子为 0 时应抛出明确异常`() {
    val ex = assertThrows<ValidationException> {
        Signal(factor = 0.0, offset = 1.0)
    }
    assertTrue(ex.message!!.contains(“factor”))
}
集成测试:SDK 内置 Mock Server
// 2. 集成测试:SDK 内置 Mock Server
class MockServer(private val port: Int) {
    fun expectResponse(path: String, body: String, status: Int = 200) { /* ... */ }
    fun start() { /* ... */ }
    fun stop() { /* ... */ }
}

@Test
fun `使用内置 MockServer 测试完整请求链路`() {
    val mock = MockServer(8080).apply {
        expectResponse(“/api/v1/user”, “””{“name”:”张三”}”””)
        start()
    }
    val sdk = SdkClient(SdkConfig.Builder().baseUrl(“http://localhost:8080”).build())
    assertEquals(“张三”, sdk.getUser().name)
    mock.stop()
}
CI 自动化:每次提交触发
# 3. CI 自动化:每次提交触发
# .github/workflows/test.yml
# - 单元测试
# - 静态代码扫描(detekt / ktlint)
# - 构建检查
# - 兼容性检查(用上一个版本的调用方代码跑一遍当前 SDK)
反面例子
- 给别人用的网络
SDK,没有任何Mock工具,要求使用者自己mock整个HTTP层 - 测了正常路径,没有测异常情况: ”传
null会怎样”、”网络断了会怎样”、”并发调用会怎样” - 依赖”本地能跑”来判断质量,没有
CI
💡 你能想到的边界条件不去测试,使用者在生产环境就会替你测。
七、 📖 良好的文档和示例
注
一句话定义:使用者的第一行代码是在 README 里复制的,不是自己写的。文档就是 SDK 的产品界面。
文档的最低构成
📁 sdk-project/
├── README.md          ← 安装步骤 + 30 秒快速开始
├── examples/           ← 完整可运行的示例代码,每次发布前必须编译通过
├── docs/
│   ├── api-reference/  ← 每个接口的参数、返回值、异常说明
│   └── migration/      ← 版本升级时的变更说明
└── CHANGELOG.md        ← 每个版本的改动记录
快速开始:30 秒原则
README 的开头必须有一段”复制 → 粘贴 → 运行”就能看到效果的最小代码:
// ✅ 30 秒能跑起来的最简示例
// 1. 添加依赖
implementation(“io.github.shilic:smart-dbc:1.0.11”)

// 2. 三行代码看到结果
// 1. 读取 DBC 文件;DBC对象中使用树形结构保存了DBC文件中的所有信息。
val dbc: DataBaseCan = File("example.dbc")::inputStream.toDbc()
// 2. 解码 CAN 报文只需一行; 自动将CAN报文解析为物理值,并保存到DBC对应的信号中。
dbc.decodeCanFrame(canFrame)
// 3. 按消息 ID 查看解析结果,内置索引器快速查找报文
dbc[0x18ABAB01]?.also { println(it.valueInfo) }
FAQ 和排错指南
README 里至少回答:依赖冲突了怎么办?超时时间怎么调?怎么在 Android 上使用?错误码在哪查?每一个你回答过的 GitHub Issue,都应该成为 FAQ 里的一条。
反面例子
- 只有一个空
README,写”请参考源码” README上的示例是1.0的API,实际已经2.0——复制的第一行就编译不过examples/目录里的代码从来没编译过
💡 好的文档不教用户怎么”用”你的
SDK——而是帮他解决”用你的SDK时遇到的问题”。
八、 🔄 CI/CD:SDK 的信任担保机制
注
一句话定义:CI/CD是 SDK 对使用者的信任担保机制——每一次发布都经过验证,每一个版本都可追溯。
💡 CI(Continuous Integration,持续集成):确保代码的质量
每次合并到主分支前,CI 必须跑过全部检查,否则不予合并:
| 门禁 | 做什么 |
|---|---|
| 兼容性 | 用上一个版本的调用方代码跑一遍当前 SDK——跑不通说明有不兼容改动 |
| 质量 | 单元测试 ≥ 80% + 集成测试 |
| 静态代码扫描 | 依赖冲突检查、安全漏洞扫描、代码风格检查 |
| 示例代码编译 | examples/ 下的所有代码必须能编译并运行通过 |
💡 CD(Continuous Delivery,持续交付):确保代码能随时安全地交付
CD 建立在 CI 之上——如果 CI 没过,就不应该进入 CD 阶段。
1. 版本号自动管理:杜绝人为错误
版本号根据 commit message 自动生成,不允许手动修改:
| Commit 类型 | 版本号变化 | 示例 |
|---|---|---|
fix: | 补丁 +1 | 1.2.3 → 1.2.4 |
feat: | 次版本 +1 | 1.2.3 → 1.3.0 |
BREAKING CHANGE: | 主版本 +1 | 1.2.3 → 2.0.0 |
2. 发布前自检:别把坏包传到中央仓库
执行release时,自动从commit message生成 CHANGELOG,不允许“发布完了再补”。
执行自动化测试,测试全部通过后,自动推送至包管理器(npm, Maven Central, PyPI 等)。
回到TSMaster API反面例子
同星 TSMaster API 问题——API 被删除、版本不兼容、用户必须安装特定版本才能用。如果有 CI/CD:
- 兼容性测试: 会在合并前发现
tsfifo_receive_can_message_list被删除,CI直接失败,迫使开发者要么恢复旧函数,要么升主版本。 - 自动版本管理: 会让这种破坏性变更自动触发主版本号 +1,使用者看到
2.0.0就知道“这次升级需要改代码”。 - 自动发布: 会确保发布的
DLL版本和API文档版本一致,不会出现“手册写的是新版,用户装的是旧版”的混乱。
同星的问题不是技术问题,是工程流程问题。CI/CD 就是解决这个问题的。
💡 CI/CD 不是”自动化工具”,而是 SDK 开发者对使用者的承诺兑现机制。没有 CI/CD 的 SDK,就像没有质检的生产线——你也许能做出好产品,但你没法让客户相信你每次都能做出好产品。
总结
回到开篇那句话——SDK 是把通用代码分离出来,让别人通过依赖使用。但”能用”和”好用”之间,差了这篇文章里讲的每一件事。
一、接口契约告诉你:发布的接口就是承诺,不要偷偷改。同星 TSMaster 删了一个函数,所有使用者的上位机全部瘫痪——这就是违约的代价。
二、最小惊奇告诉你:好的设计不需要说明书。门把手、USB-C、雨量传感器——所有好设计的共同点都是”你看到的那一刻动作已经定了”。SDK 的命名、参数顺序、副作用,都应该遵循同一个原则。
三、最小依赖告诉你:你的 SDK 是客人,别带一车行李进主人家门。能用标准库就别引入三方库,能 compileOnly 就别 implementation。
四、错误即信息告诉你:告诉调用方”出错了”没用,告诉它”接下来该怎么办”才有用。周立功的 -1 和 Vector 的 KGRE_BufferToSmall,差的就是这层语义。
五、日志告诉你:不要替使用者决定日志去哪。用门面,别用 println。
六、测试告诉你:SDK 的 bug 影响所有使用者。你没测到的边界条件,使用者在生产环境替你测。
七、文档告诉你:使用者的第一行代码是在 README 里复制的。30 秒跑不通第一个 Demo,他不会再给你第二次机会。
八、CI/CD告诉你:信任不是靠嘴说的,是靠每一次 CI 绿勾和干净的 CHANGELOG 一点一点攒出来的。
本文从头到尾拿同星 TSMaster、周立功、Vector 的真实代码做对比。好的 SDK 和烂的 SDK 之间,差的不是技术,是把使用者的感受当回事。